
Miroir magique : quelles technologies pour un miroir interactif en 2026 ?
Un miroir magique arrête des gens qui passaient. Ils se voient, puis se voient autrement : en costume de super-héros dans une boutique de vêtements, en uniforme de facteur des années 1950 dans un musée, en blouse sur un stand pharmaceutique. Ils restent, essaient un autre look, et repartent avec une photo ou un clip que leurs proches verront. Pour une marque, c’est du temps passé, un produit réellement essayé, et du contenu partagé par les visiteurs eux-mêmes.
Derrière le cadre, il y a toujours quatre éléments : un écran, une caméra, un ordinateur et un logiciel qui comprend un corps. Ce qui change d’un miroir à l’autre, c’est ce logiciel, et surtout sa manière d’habiller le visiteur. En 2026, deux familles coexistent : la réalité augmentée, qui pose un vêtement 3D sur un squelette qu’elle suit, et l’IA générative, qui redessine l’image du visiteur. Cet article passe chaque couche en revue, puis vous aide à choisir.
Le matériel : un écran, une caméra, un ordinateur
Vrai miroir ou miroir vidéo. Deux conceptions portent le même nom. La première place un miroir sans tain, un verre semi-réfléchissant, devant un écran : là où l’écran est noir, le verre reflète comme un miroir ordinaire ; là où il s’allume, l’image transparaît. Ce verre ne laisse passer qu’une partie de la lumière : 20 % pour le MirroView standard de Pilkington, 49 % pour sa version 50/50 conçue pour les commerces, si bien que l’écran derrière tourne à pleine luminosité. La seconde n’a pas de miroir du tout : une caméra filme le visiteur et l’écran affiche l’image inversée gauche-droite, comme le ferait un miroir. La première fait son effet quand quelques éléments apparaissent autour d’un vrai reflet. Mais un vrai reflet ne peut jamais être redessiné : pour poser un vêtement sur le visiteur, son image doit venir de la caméra. C’est pourquoi les miroirs d’essayage, dont celui d’ARGO, sont des miroirs vidéo.
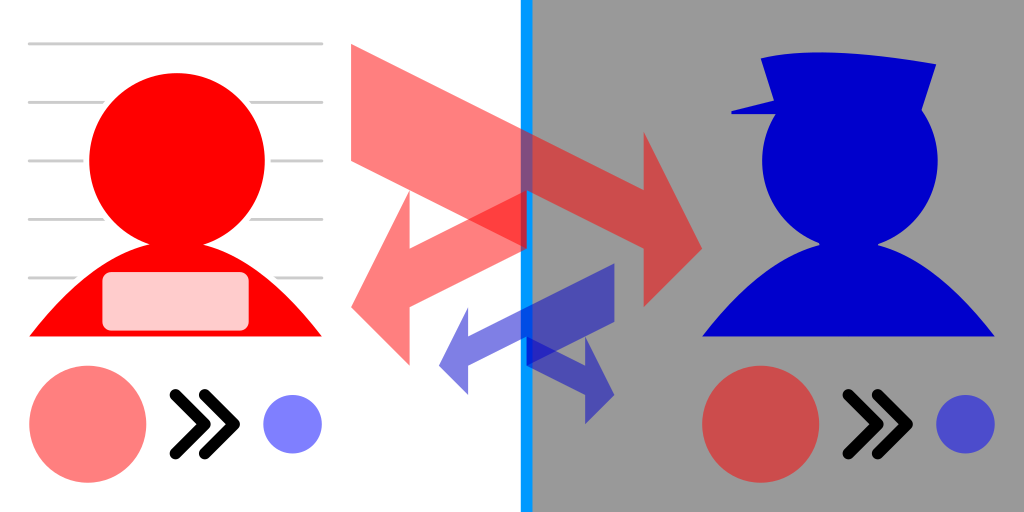
Le principe du miroir sans tain : les deux côtés voient surtout le côté le plus lumineux. Derrière un miroir-écran, l’écran est le côté lumineux partout où il s’allume.
Image : Cmglee, CC BY-SA 4.0, via Wikimedia Commons (rastérisé, converti en WebP).L’écran. Un grand écran en format portrait, pour qu’un adulte y tienne de la tête aux pieds, dans un habillage qui cache les câbles, l’ordinateur et la caméra. Dans une galerie commerciale baignée de lumière, la luminosité compte davantage que la résolution.
La caméra. Une caméra RGB standard suffit aujourd’hui pour la plupart des usages : les modèles d’IA de la partie suivante estiment le squelette sur une image ordinaire. Ce qui compte, c’est le champ de vision (voir un corps entier à deux ou trois mètres), la hauteur à laquelle elle est fixée, et la lumière : un visiteur à contre-jour devant une vitrine est le piège classique. Certains miroirs ajoutent une caméra de profondeur, qui mesure la distance de chaque pixel ; nous y revenons plus bas.
L’ordinateur. Un petit PC doté d’une puce graphique, dans l’habillage. Il fait tourner soit une application native (Unity, Unreal), soit, de plus en plus, un navigateur web en plein écran : la caméra, les modèles d’IA et le rendu 3D tournent tous dans la page, via WebGL ou WebGPU. Mettre à jour une expérience revient alors à publier une page web, pas à réinstaller un logiciel.
Autour : une dalle tactile ou aucune (un miroir piloté par les gestes n’a pas de vitre à nettoyer), une imprimante pour les photos souvenirs, et une connexion réseau pour livrer les contenus et le QR code qui permet aux visiteurs de garder leur photo.
Détecter le visiteur
Avant d’habiller qui que ce soit, le miroir doit savoir que quelqu’un est là. La méthode la plus simple compare chaque image à la précédente : quand assez de pixels changent, quelqu’un bouge devant l’écran. Cela ne coûte presque rien et sort le miroir de sa boucle d’attente, la vidéo qui tourne pour attirer le regard. Des détecteurs plus fins repèrent une personne ou un visage, ce qui permet de distinguer un visiteur face au miroir de quelqu’un qui passe derrière lui.
Comprendre le corps
C’est ici que se joue vraiment un miroir magique. Pour poser une manche sur un bras, le logiciel doit savoir où est le bras, à chaque image.
L’estimation de pose avec une caméra standard
Un modèle d’estimation de pose prend une image et renvoie la position des articulations du corps, les points clés. Deux formats dominent. Le premier, les 17 points du jeu de données COCO, utilisé par MoveNet de Google (2021), compte 17 points clés : nez, yeux, oreilles, épaules, coudes, poignets, hanches, genoux, chevilles. Le second, BlazePose, le modèle derrière le Pose Landmarker de MediaPipe, renvoie 33 repères : il ajoute les mains, les pieds et davantage de points du visage, et donne aussi chaque point en coordonnées 3D. La référence de recherche qui a popularisé le domaine, OpenPose, a été publiée par l’université Carnegie Mellon en 2017 ; sa licence la réserve à la recherche non commerciale.
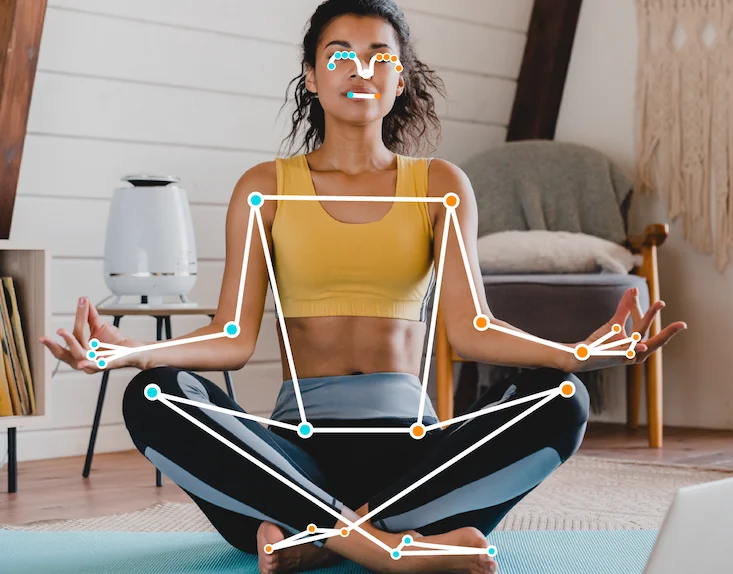
Le Pose Landmarker de MediaPipe sur une photo ordinaire : chaque point est un repère, chaque trait en relie deux.
Image : Google, CC BY 4.0, via Wikimedia Commons (converti en WebP).Ces modèles tournent en temps réel sur une puce graphique modeste, et dans un navigateur web : MediaPipe les publie pour le web, exécutés sur le GPU. C’est ce qui permet à un miroir magique de fonctionner avec une simple webcam et une page web.
Google montre le Pose Landmarker de MediaPipe dans une page web : les 33 repères, en temps réel, depuis une webcam.
Vidéo : Google for Developers, sur YouTube.Ce que voit la caméra
- 17 points clés
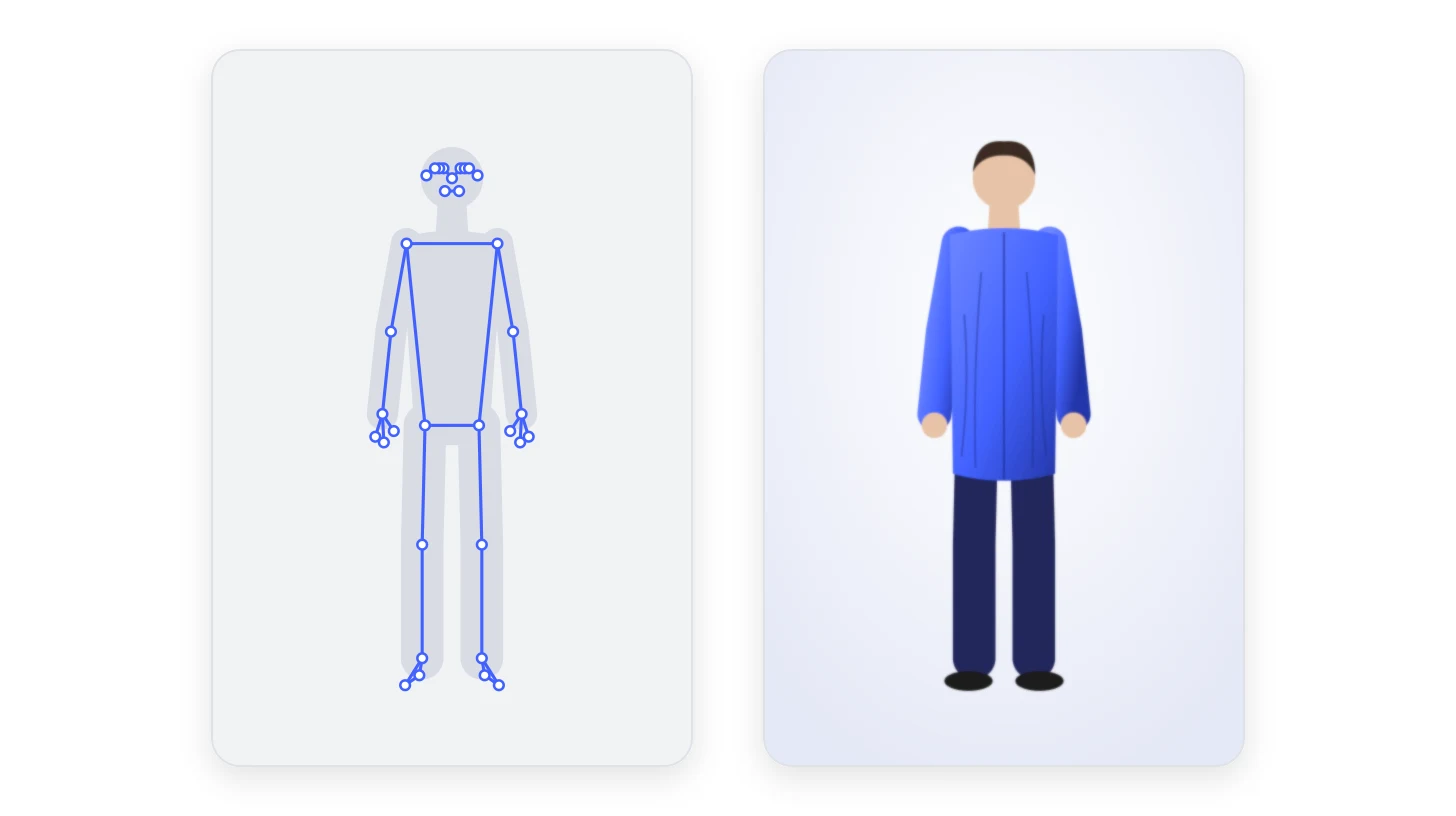
- Le squelette classique, au format COCO qu’utilise MoveNet : nez, yeux, oreilles, épaules, coudes, poignets, hanches, genoux et chevilles.
- Permet au miroir : accrocher un vêtement 2D ou 3D au torse et aux membres, jouer avec des gestes, savoir combien de personnes se tiennent devant le miroir.
- 33 repères
- BlazePose, dans MediaPipe, ajoute les mains (pouce, index, auriculaire), les pieds (talon, orteils) et des points du visage, et estime la profondeur de chaque point.
- Permet au miroir : des manches qui suivent les poignets, un pantalon et des chaussures posés sur les pieds, un vêtement qui tourne avec le corps.
- Masque de la personne
- La segmentation classe chaque pixel de l’image : personne ou arrière-plan.
- Permet au miroir : remplacer le décor par un univers de marque, et masquer les parties d’un vêtement qui passent derrière un bras ou les cheveux.
- Maillage du visage
- Un maillage dense du visage : MediaPipe Face Landmarker renvoie 478 points en 3D. Seul un échantillon est dessiné ici.
- Permet au miroir : des lunettes, du maquillage, des chapeaux et des masques qui restent en place quand la tête tourne.
Un mannequin debout et quatre lectures qu’un miroir magique peut en faire : 17 points clés du corps ; 33 repères, mains et pieds compris ; un masque qui sépare le corps de l’arrière-plan ; un maillage du visage. Chaque lecture indique ce qu’elle permet au miroir.
Chaque lecture de l’image ouvre un type d’expérience différent. Les coordonnées sont dessinées à la main ; les listes de points suivent MoveNet (17) et BlazePose (33).
Les caméras de profondeur
Une caméra de profondeur mesure, pour chaque pixel, la distance à la scène. La Kinect de Microsoft l’a rendue célèbre ; sa dernière version, l’Azure Kinect, était livrée avec un kit de suivi du corps qui renvoyait un squelette 3D. Microsoft a arrêté sa production en août 2023 et a transmis la technologie à Orbbec, dont la Femto Bolt utilise le même module de profondeur et peut faire tourner le logiciel de suivi du corps de Microsoft grâce à une couche de compatibilité. Les caméras RealSense jouent un rôle comparable ; Intel en a fait une entreprise indépendante en juillet 2025.
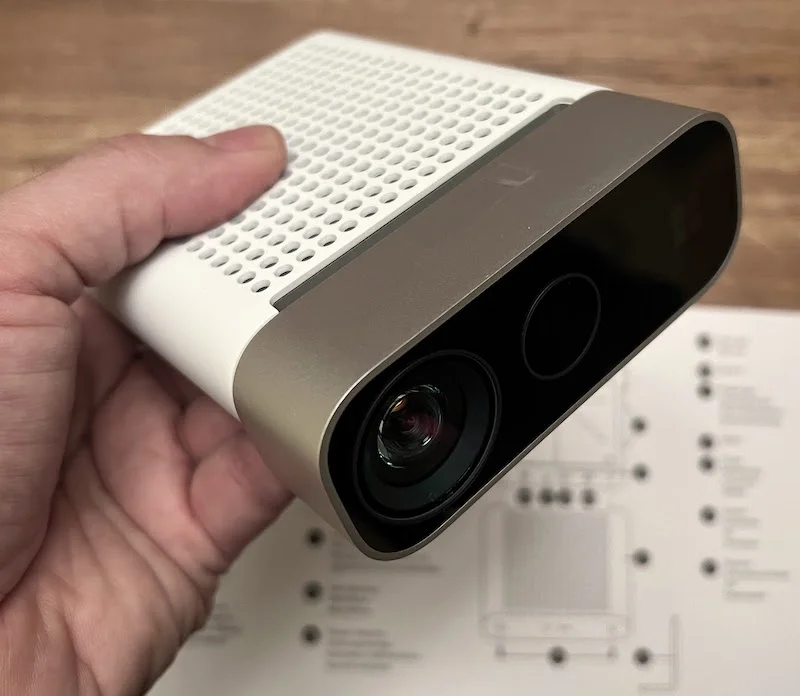
L’Azure Kinect DK, la caméra de profondeur de Microsoft avec son logiciel de suivi du corps, produite jusqu’en 2023.
Image : Profkipp, CC BY-SA 4.0, via Wikimedia Commons (converti en WebP).La profondeur rend le suivi plus robuste : elle sépare deux personnes qui se chevauchent, supporte mieux une lumière faible, et sait exactement ce qui est devant quoi. Le prix : un matériel spécifique, des pilotes, et en pratique une application native. Pour un miroir qui voyage d’événement en événement, une caméra standard et un navigateur sont plus simples à déployer et à maintenir.
Les caméras Femto d’Orbbec font tourner les exemples écrits pour l’Azure Kinect : le squelette vient du capteur de profondeur.
Vidéo : Orbbec, sur YouTube.Masques, visages, mains et morphologie
Trois autres lectures complètent le squelette. La segmentation détoure la personne, pixel par pixel : c’est elle qui permet à un photobooth de remplacer le décor par un univers de marque, et à un vêtement de passer derrière un bras. Le maillage du visage place des centaines de points sur le visage pour des lunettes, du maquillage ou un chapeau. Le suivi des mains suit les doigts, pour des gestes ou une bague. Et la recherche va plus loin : des modèles paramétriques du corps comme SMPL décrivent toute la forme 3D d’un corps avec quelques paramètres, ce qui ouvre la voie à des vêtements ajustés à la morphologie réelle du visiteur.
Habiller le visiteur en réalité augmentée
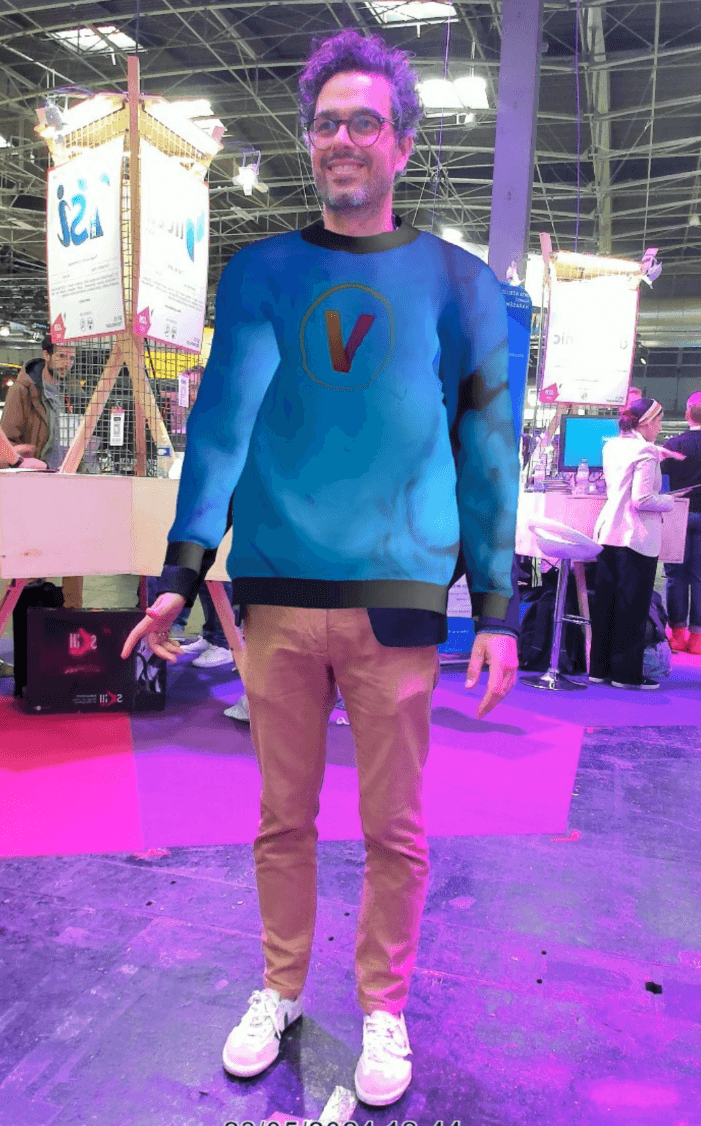
En réalité augmentée, le vêtement existe avant l’arrivée du visiteur : c’est un modèle 3D, généralement un fichier glTF, doté d’un squelette interne (on dit qu’il est rigué). À chaque image, le logiciel aligne ce squelette sur les points clés du visiteur et le moteur 3D, three.js dans un navigateur par exemple, dessine le vêtement par-dessus l’image de la caméra. Une animation secondaire fait onduler une cape ou une jupe ; le masque de la personne cache ce qui doit passer derrière un bras ; l’éclairage s’ajuste à la scène.
La force de cette approche, c’est la fidélité : le vêtement est le produit, avec ses couleurs, ses logos et ses motifs exacts, puisqu’ils viennent de son modèle 3D. Elle réagit instantanément, tourne entièrement sur la borne, et le même squelette pilote jeux et gestes. Sa limite, c’est le tissu : un vêtement 3D suit le corps mais ne fait qu’approcher la façon dont l’étoffe tombe et se plisse. Et chaque nouveau look commence par un modèle 3D à créer ou à adapter. Une variante moins coûteuse accroche une image 2D plate du produit aux points clés : rapide à produire, convaincante de face, moins quand le visiteur se tourne.
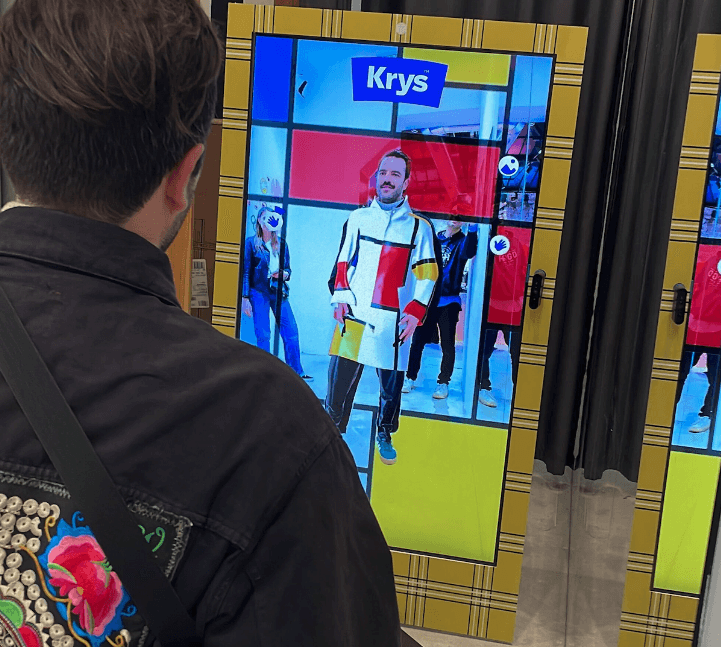
C’est la famille qui porte la plupart de nos projets : tenues Superman co-brandées chez Celio, uniformes historiques au Musée de La Poste, tenues 3D dans les centres Westfield, blouses et costumes sur un stand Sanofi lors d’un congrès de dermatologues.
Habiller le visiteur avec l’IA générative
L’IA générative renverse la logique : le vêtement n’est pas posé sur l’image, l’image est redessinée avec le vêtement. Deux produits très différents en découlent.
L’essayage sur photo. Le miroir prend une photo ; un modèle d’image reçoit la photo et une image du vêtement, et génère le visiteur qui le porte. Depuis 2024, des modèles de recherche comme IDM-VTON, OOTDiffusion ou CatVTON ont rendu ce type de rendu convaincant : les plis, la lumière et le tombé du tissu sonnent juste, à partir d’une simple photo produit, sans modélisation 3D. Leur code est public, mais sous licence non commerciale : un miroir commercial s’appuie sur un modèle ou un service sous licence. Mais c’est une image fixe, produite après une courte attente : parfaite pour un souvenir, pas pour un miroir devant lequel on bouge.
L’essayage sur photo chez Google : la photo du visiteur, habillée par un modèle génératif dans le vêtement choisi.
Vidéo : Google, sur YouTube.L’essayage en vidéo directe. La dernière étape, ce sont des modèles vidéo assez rapides pour transformer un flux de caméra pendant qu’il défile. La recherche s’en rapproche depuis StreamDiffusion, qui transformait jusqu’à 91 images par seconde sur une seule carte graphique RTX 4090 fin 2023, et les travaux de 2025 qui génèrent la vidéo en flux continu avec moins d’une seconde de latence. La borne envoie son flux à un GPU dans le cloud, le modèle redessine chaque image dans la tenue choisie, et la vidéo transformée revient à l’écran. Le visiteur bouge, se tourne, lève un bras, et le tissu suit. Une nouvelle tenue ne demande qu’une photo produit ou une phrase, et le même miroir peut transformer un visiteur en costume ou en personnage.
Un essayage en direct présenté sur scène à SIGGRAPH Asia 2024 : l’image de la caméra est redessinée en temps réel avec le vêtement. Ce prototype de recherche entraîne un réseau génératif par vêtement plutôt qu’un modèle de diffusion vidéo, mais l’expérience est la même : on bouge, et le vêtement suit.
Vidéo : Zaiqiang Wu, sur YouTube.Les limites sont aussi réelles que l’effet. Le modèle interprète le vêtement : un logo ou un motif fin peut ressortir approximatif. Il doit rester cohérent d’une image à l’autre. Il exige une connexion rapide et stable, puisque chaque image fait l’aller-retour. Chaque minute d’usage coûte du temps de GPU. Et la vidéo quitte la borne, ce qui change la question de la vie privée.
Cinq étapes, trois façons d’habiller le visiteur
-
1Capter
Réalité augmentée
Sur la borne
Une caméra standard filme le visiteur en continu.
IA, photo
Sur la borne
La caméra prend une photo une fois le visiteur en place.
IA, vidéo en direct
Sur la borne
Le flux de la caméra quitte la borne en continu.
-
2Détecter
Réalité augmentée
Sur la borne
La détection de mouvement ou de personne sort le miroir de sa boucle d’attente.
IA, photo
Sur la borne
La détection de mouvement ou de personne sort le miroir de sa boucle d’attente.
IA, vidéo en direct
Sur la borne
La détection de mouvement ou de personne réveille le miroir et ouvre la session vidéo.
-
3Comprendre
Réalité augmentée
Sur la borne
Un modèle de pose retrouve le squelette dans chaque image.
IA, photo
Dans le cloud
Le modèle d’essayage lit le corps, la pose et le vêtement sur la photo.
IA, vidéo en direct
Dans le cloud
Le modèle vidéo lit le corps et ses mouvements dans chaque image.
-
4Dessiner
Réalité augmentée
Sur la borne
three.js dessine le vêtement 3D sur le squelette, par-dessus l’image de la caméra.
IA, photo
Dans le cloud
Un modèle d’image peint le vêtement sur la photo, après une courte attente.
IA, vidéo en direct
Dans le cloud
Le modèle redessine chaque image dans la tenue et renvoie la vidéo.
-
5Partager
Réalité augmentée
Dans le cloud
La photo ou le clip est envoyé en ligne ; un QR code permet au visiteur de le garder.
IA, photo
Dans le cloud
L’image est affichée, puis partagée par QR code.
IA, vidéo en direct
Dans le cloud
Un clip de la session est enregistré et partagé par QR code.
Tout ce qui regarde le corps reste sur la borne. À 30 images par seconde, chaque image dispose de 33 millisecondes pour être analysée et dessinée ; seul le souvenir quitte la borne.
Le visiteur attend une image au lieu de se voir bouger : idéal pour une photo souvenir, pas pour un miroir vivant.
Chaque image fait l’aller-retour jusqu’à un GPU : le réseau compte autant que le modèle.
Les cinq étapes de tout miroir magique, capter, détecter, comprendre, dessiner, partager, pour trois approches : réalité augmentée, IA sur photo, IA en vidéo directe. Chaque étape dit ce qu’elle fait et si elle tourne sur la borne ou dans le cloud.
L’endroit où tourne chaque étape distingue les approches autant que le rendu lui-même.
Comment choisir
| Superposition 2D | AR 3D, caméra standard | AR 3D, caméra de profondeur | Essayage IA, photo | Essayage IA, vidéo en direct | |
|---|---|---|---|---|---|
| En direct | Oui | Oui | Oui | Non | Oui |
| Produit exact | Oui, à plat | Oui | Oui | Interprété | Interprété |
| Tombé et lumière | Non | Approchés | Approchés | Photoréalistes | Photoréalistes |
| Un nouveau look demande | Une image produit | Un modèle 3D | Un modèle 3D | Une image produit | Une image produit ou une phrase |
| Réseau | Standard | Standard | Standard | Nécessaire à chaque photo | Rapide et stable |
| Coût à l’usage | Aucun | Aucun | Aucun | À l’image | À la minute |
La bonne approche dépend de ce que l’activation doit produire. Une enseigne qui veut faire voir son produit exact et faire jouer ses visiteurs plusieurs jours choisira la réalité augmentée 3D. Une marque qui lance une collection et veut l’effet waouh et une vidéo qui circule choisira l’IA en direct. Beaucoup d’activations combinent les deux : des jeux en réalité augmentée la journée, un moment IA le soir de l’inauguration.
Quelle approche pour quelle activation
Aucune approche ne fait tout cela : décochez un besoin.
-
Superposition 2D sur le squelette
Une image plate du produit accrochée aux points clés. Rapide à produire, mais elle ne tourne pas avec le corps.
- De se voir bouger, en direct
- Le produit exact (logos, motifs)
- De nouveaux looks sans modélisation 3D
- De fonctionner sur une connexion faible
- Des jeux et des gestes avec le corps
- Lunettes, maquillage, chapeaux
- Une caméra standard
- Aucun coût de calcul à l’usage
-
Réalité augmentée 3D, caméra standard
Un vêtement 3D rigué sur un squelette estimé depuis une webcam et dessiné en temps réel. Le mode AR d’ARGO.
- De se voir bouger, en direct
- Le produit exact (logos, motifs)
- De fonctionner sur une connexion faible
- Des jeux et des gestes avec le corps
- Lunettes, maquillage, chapeaux
- Une caméra standard
- Aucun coût de calcul à l’usage
-
Réalité augmentée 3D, caméra de profondeur
Le même rendu, avec un capteur de profondeur et son logiciel de suivi du corps : un suivi plus robuste, un matériel plus cher, un logiciel natif.
- De se voir bouger, en direct
- Le produit exact (logos, motifs)
- De fonctionner sur une connexion faible
- Des jeux et des gestes avec le corps
- Une vraie profondeur (foule, lumière difficile)
- Aucun coût de calcul à l’usage
-
Essayage IA, photo
Un modèle d’image habille une photo du visiteur à partir d’une image du produit. Photoréaliste, mais pas en direct.
- Un tombé et une lumière photoréalistes
- De nouveaux looks sans modélisation 3D
- Une caméra standard
-
Essayage IA, vidéo en direct
Un modèle vidéo redessine le visiteur image par image dans la tenue choisie. L’option IA générative d’ARGO.
- De se voir bouger, en direct
- Un tombé et une lumière photoréalistes
- De nouveaux looks sans modélisation 3D
- Une caméra standard
Cochez ce dont votre activation a besoin ; la liste garde les approches qui font tout cela, parmi cinq : superposition 2D sur le squelette, réalité augmentée 3D avec une caméra standard, réalité augmentée 3D avec une caméra de profondeur, essayage par IA sur photo, essayage par IA en vidéo directe.
Chaque approche est présentée avec ce qu’elle fait dans sa configuration habituelle : un modèle d’essayage sur photo peut tourner sur un GPU local, par exemple, mais il est en général servi depuis le cloud.
Vie privée
Un miroir magique filme des personnes : la question revient dans chaque projet. En réalité augmentée, l’image est analysée sur la borne : le squelette est calculé à chaque image puis aussitôt oublié, et rien ne sert à reconnaître qui que ce soit. Les données biométriques du RGPD se définissent par leur finalité : des données issues d’un traitement technique spécifique qui permettent ou confirment l’identification unique d’une personne. Un miroir qui pose une veste sur une paire d’épaules n’identifie personne. La CNIL fait la même distinction pour les « caméras augmentées » qui analysent les personnes dans les commerces : ce n’est pas de la reconnaissance biométrique, mais elles posent leurs propres questions, d’information et de droit d’opposition avant tout.
Avec l’IA générative, la vidéo quitte la borne pour être transformée dans le cloud. Cela suppose une information claire à côté du miroir, un prestataire lié par un contrat de sous-traitance, et une durée de conservation courte pour les clips que les visiteurs emportent. Dans les deux cas, la photo ou la vidéo qu’un visiteur garde via un QR code est une donnée personnelle, à traiter comme telle.
Chez ARGO
Notre Miroir Magique fonctionne avec une caméra standard, une estimation de pose par IA et three.js dans un navigateur web : vêtements 3D rigués sur le squelette, photobooth avec décors, jeux avec le corps, et un QR code pour garder le souvenir. Il propose désormais aussi, en option, l’essayage par IA générative en direct : le visiteur se voit redessiné dans la tenue, et repart avec la vidéo.
Le miroir arrive configuré et s’installe en moins de deux heures. Il a été déployé pour Westfield, Celio, le Musée de La Poste, Sanofi, Krys et le stand de la CAPEB aux WorldSkills à Lyon. Pour voir les deux modes, réalité augmentée et IA, devant vos propres produits : découvrez le Miroir Magique.
FAQ